KI-Workflows, die wirklich im Produktivbetrieb laufen.
Wir überführen Ihre Daten in eine produktionsreife Pipeline, entwickeln darauf die Workflows, die Ihr Unternehmen braucht, und übergeben sie dann an Ihre Teams. Kein Modell in der Sandbox. Keine Berater, von denen Sie abhängig sind. Funktionierende Systeme, die Ihnen gehören.
Warum so viele KI-Investitionen nichts bringen
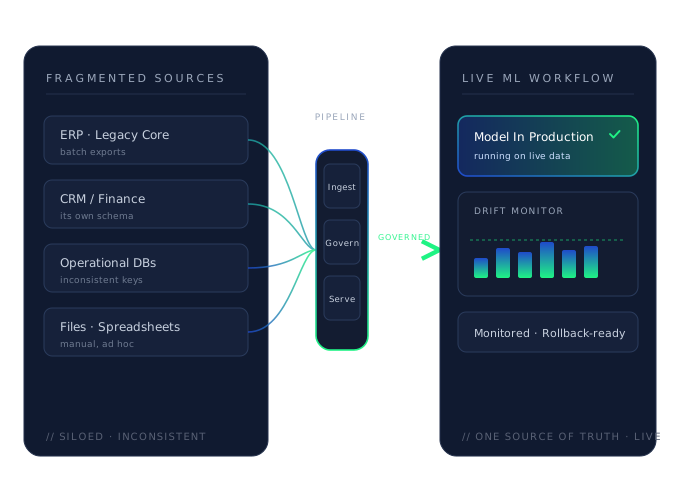
Sie haben es wahrscheinlich schon versucht: ein Modell entwickelt, ein Pilotprojekt durchgeführt und anschließend versucht, das Modell im Produktivbetrieb einzusetzen – bis Sie auf zwei Hürden stießen. Erstens waren Ihre Daten nicht bereit: fragmentiert und inkonsistent über ältere Kernsysteme, Finanzsysteme und operative Datenbanken verteilt, die auf die Fragen von gestern ausgelegt waren, nicht auf die Anforderungen von KI. Zweitens erfordert der Betrieb eines Modells in großem Maßstab – mit Monitoring, Rollback und Governance – technische Arbeit für den Produktivbetrieb, auf die Ihr internes Team nie ausgerichtet war, selbst wenn die Daten sauber sind. Laut Eurostat konnten 57,5 % der EU-Unternehmen, die 2023 IKT-Fachkräfte einstellen wollten, diese Stellen nicht besetzen. So scheitert das Pilotprojekt oder geht als Nebenprojekt in Betrieb, das niemand nutzt – das Geld ist ausgegeben, vorzuweisen gibt es nichts. Nicht, weil KI nicht funktioniert, sondern weil die Datengrundlage und die technische Umsetzung für den Betrieb fehlten.
Quelle: Eurostat, ICT specialists – statistics on hard-to-fill vacancies in enterprises, 2023.
Was Sie mitnehmen
Eine einheitliche Datengrundlage: fragmentierte Systeme, zusammengeführt in einer produktionsreifen Datenbasis mit klarer Governance für Compliance und Qualität, damit Ihre ML-Workflows verlässliche Eingangsdaten haben.
KI-Workflows, die live gehen: Modelle im Einsatz in Ihren Abläufen, im Zusammenspiel mit Ihrem Team und messbar an echten Geschäftsergebnissen – keine Laborexperimente.
Integrierte Schutzmechanismen für den Produktivbetrieb: Monitoring, das Drift in einem Workflow erkennt, ein Rollback, den Sie steuern, und eine Logik für erneutes Training, die die Genauigkeit aufrechterhält – damit Sie nie von einem unbemerkten Ausfall überrascht werden.
Nachweis des ROI: eine klare Messung dessen, was der Workflow leistet – eingesparte Zeit, bessere Entscheidungen, freigesetzte Kapazität und Veränderungen beim Umsatz –, keine Vanity-Metriken.
Alles gehört Ihnen: Ihr Team besitzt Code, Pipelines, Modelle und Infrastruktur und kann sie ohne uns weiterentwickeln. Kein Lock-in, keine dauerhafte Abhängigkeit von Beratern.
So arbeiten wir in der Regel
Daten-Audit
Wir erfassen und bewerten jede Datenquelle und benennen Compliance-Risiken. Sie erhalten einen priorisierten Konsolidierungsplan – was in welcher Reihenfolge zu beheben ist.
Pipeline-Aufbau
Wir führen die Daten Ihrer Quellen in einem Datenspeicher mit klarer Governance zusammen und automatisieren den Datenfluss. Sie erhalten eine Pipeline im Betrieb, auf der Ihre ML-Workflows laufen können.
Modellentwicklung
Wir entwickeln die ML-Workflows und validieren sie an realen Szenarien, nicht an Laborstichproben. Sie erhalten produktionsreife Modelle mit dokumentierten Fehlerszenarien.
Produktivsetzung
Wir nehmen die Modelle in Betrieb – mit Drift-Monitoring, Rollback bei Fehlern und definierten Auslösern für erneutes Training. Sie erhalten laufende Workflows und ein Dashboard, das zeigt, was sie leisten.
Übergabe
Wir übergeben Code, Pipelines und Runbooks und schulen Ihr Team. Das System gehört Ihnen; wir bleiben auf Abruf erreichbar.
Laufender Support
Fehlerbehebung, erneutes Training der Modelle und Architekturberatung – wenn und wann Sie es möchten.
Wo wir Daten-Workflows in großem Maßstab umgesetzt haben
Die Ergebnisse finden Sie in unseren Fallstudien
Häufig gestellte Fragen
Starten Sie mit einem kostenlosen Data Estate Audit
Kostenlos · 10 Minuten, zum Selbstausfüllen: Finden Sie anhand konkreter Belege heraus, welche Ihrer geplanten KI-Ergebnisse sich mit Ihren aktuellen Daten tatsächlich erzielen lassen – Kostenloses Data Estate Audit. Möchten Sie die vollständige Version mit praktischer Unterstützung? Das vollständige Data Estate Audit ist Teil unserer Leistung KI-Strategie & Beratung. Danach entscheiden Sie, ob Sie die Umsetzung angehen.
Free Data Estate Audit →